Foto e voce di riferimento: come ottenere un avatar realistico
La qualità di un avatar video dipende tanto dal modello di generazione quanto dai dati che gli vengono forniti. Una foto esposta male può compromettere la fedeltà dei tratti del viso, mentre un campione vocale con rumore può peggiorare la riproduzione della voce e la sincronizzazione audiovisiva.
Sommario
- Comprendere il ruolo dei riferimenti nella generazione
- Ottimizzare la foto di riferimento per preservare l’identità facciale
- Controllare illuminazione, contrasto e inquadratura
- Preparare un campione vocale adeguato
- Comprendere la durata e il contenuto della voce di riferimento
- Adattare il copione alla sintesi vocale e alla sincronizzazione labiale
- Verificare la coerenza audiovisiva
- Adottare un metodo di test riproducibile
- Gli errori tecnici più frequenti
Comprendere il ruolo dei riferimenti nella generazione
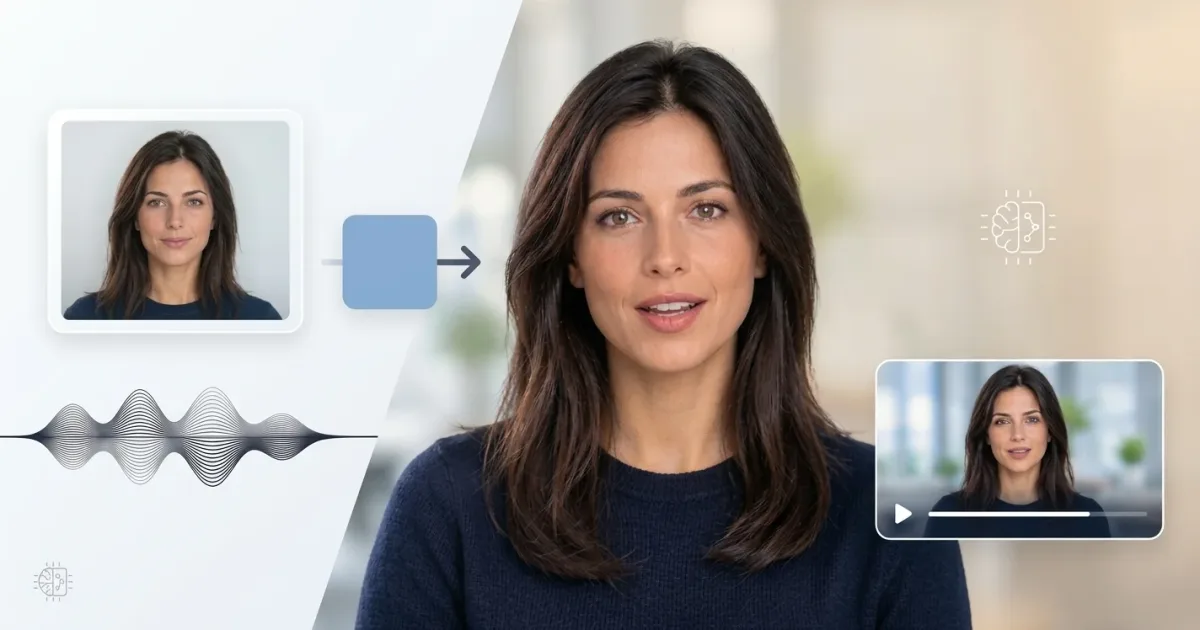
Un sistema di generazione di avatar video utilizza diverse informazioni per produrre una sequenza coerente. A seconda dell’architettura utilizzata, la foto può servire a definire l’aspetto dell’avatar, mentre l’audio o il testo guidano il parlato e, direttamente o indirettamente, i movimenti del viso.
La qualità dei riferimenti influenza quindi diversi aspetti del risultato: conservazione dell’identità, resa dei dettagli del viso, naturalezza delle espressioni e coerenza tra i movimenti delle labbra e il segnale vocale.
È importante fare una distinzione: riferimenti di alta qualità non garantiscono, da soli, una generazione perfetta. Il risultato dipende anche dal modello, dai suoi limiti e dal modo in cui interpreta gli input. L’obiettivo è fornire dati sufficientemente chiari e coerenti da ridurre le ambiguità.
Ottimizzare la foto di riferimento per preservare l’identità facciale
Per la maggior parte dei generatori di avatar basati su immagini, una foto frontale rappresenta un punto di partenza affidabile. Il viso deve essere nitido, sufficientemente grande nell’immagine e completamente visibile. Uno sguardo rivolto direttamente verso l’obiettivo e un’espressione neutra o leggermente sorridente facilitano la creazione di un aspetto stabile.
Evita rotazioni marcate della testa, elementi che nascondono parti del viso, filtri di bellezza e ritocchi che modificano la geometria facciale. Questi elementi possono complicare l’interpretazione dei tratti o favorire variazioni nell’aspetto durante il video.
La risoluzione deve consentire di distinguere chiaramente gli occhi, il naso, la bocca e i contorni del viso. Aumentare artificialmente la definizione di un’immagine sfocata non permette di recuperare i dettagli mancanti. È preferibile partire da una fotografia nitida piuttosto che affidarsi a un’elaborazione di miglioramento.
Controllare illuminazione, contrasto e inquadratura
L’illuminazione non serve soltanto a migliorare l’estetica della foto. Determina anche la visibilità delle caratteristiche facciali che permettono di distinguere volumi e contorni.
Una luce morbida, diffusa e relativamente uniforme limita le ombre marcate intorno agli occhi, al naso e alla bocca. Un controluce intenso può sottoesporre il viso, mentre una luce frontale troppo forte può appiattire alcuni rilievi e creare zone sovraesposte.
Prediligi un’inquadratura frontale, con testa e spalle visibili, se il formato lo consente. Evita ritagli estremi e prospettive insolite dovute a una fotocamera posizionata troppo in alto o troppo in basso.
Test pratico: confronta due foto della stessa persona, una scattata in controluce e l’altra rivolta verso una finestra. A parità di inquadratura, la seconda presenta generalmente tratti più leggibili e una distribuzione dei dettagli più uniforme. È proprio questa leggibilità che devi ricercare, senza confondere la nitidezza con un’accentuazione artificiale dei contorni.
Preparare un campione vocale adeguato
La voce di riferimento fornisce al sistema informazioni sul timbro, sulla texture vocale e, a seconda dello strumento, su alcuni aspetti del ritmo e dell’intonazione. La registrazione deve quindi preservare il segnale vocale senza introdurre artefatti inutili.
Registra in una stanza silenziosa, con riverbero minimo. Mantieni una distanza costante tra il microfono e la bocca, generalmente tra 10 e 20 centimetri, a seconda dell’attrezzatura, e posiziona il microfono leggermente di lato per ridurre le consonanti esplosive. Regola il livello di ingresso per evitare il clipping, ovvero la distorsione causata dalla saturazione del segnale.
Quando il servizio lo consente, preferisci una registrazione non compressa, ad esempio in formato WAV PCM. Una frequenza di campionamento di 44,1 o 48 kHz e una risoluzione di 16 bit sono scelte comuni per ottenere registrazioni pulite, ma le specifiche del generatore hanno sempre la priorità.
Evita una riduzione del rumore troppo aggressiva, il riverbero aggiunto e i trattamenti che modificano il timbro. Un segnale ripulito artificialmente può introdurre artefatti più fastidiosi del rumore originale.
Comprendere la durata e il contenuto della voce di riferimento
Un campione vocale deve essere abbastanza lungo da fornire una rappresentazione utile della voce, senza diventare inutilmente ripetitivo. La durata ottimale dipende dal sistema: alcuni strumenti funzionano con pochi secondi, mentre altri traggono vantaggio da un estratto più lungo.
Preferisci diverse frasi pronunciate in modo naturale anziché una successione di parole isolate. Le variazioni di altezza, le transizioni tra i suoni, le pause e le diverse strutture delle frasi offrono una rappresentazione più completa del modo di parlare.
Un estratto monotono potrebbe non riflettere la prosodia abituale del parlante. Al contrario, un’interpretazione eccessivamente teatrale può produrre un riferimento poco rappresentativo della sua voce quotidiana.
Utilizza esclusivamente la tua voce o una registrazione per la quale disponi delle autorizzazioni necessarie. La fedeltà tecnica non esonera dal rispetto del consenso e delle normative applicabili alla riproduzione della voce.
Adattare il copione alla sintesi vocale e alla sincronizzazione labiale
Il copione influisce direttamente sulla struttura temporale del parlato generato. Una frase lunga e ricca di informazioni può determinare un ritmo poco naturale o limitare le pause necessarie per un’esposizione fluida.
Scrivi numeri, date, abbreviazioni e acronimi in modo da rendere esplicita la pronuncia desiderata. La punteggiatura contribuisce a strutturare il ritmo, anche se il suo effetto preciso dipende dal motore di sintesi vocale utilizzato.
La sincronizzazione labiale, o lip-sync, consiste nell’allineare i movimenti della bocca al parlato. Non dipende soltanto dalla durata complessiva dell’audio: anche le transizioni tra fonemi, consonanti, vocali e silenzi svolgono un ruolo importante.
Per facilitare questo allineamento, evita formulazioni ambigue e verifica la pronuncia dei termini tecnici, dei nomi propri e degli acronimi. Se il sistema accetta audio preregistrato, assicurati che la traccia utilizzata per l’animazione corrisponda esattamente a quella riprodotta nel video finale.
Verificare la coerenza audiovisiva
Un avatar può apparire realistico in un’immagine statica e presentare comunque difetti durante l’animazione. I problemi emergono soprattutto nelle transizioni tra le espressioni, nei movimenti della mandibola, nell’ammiccamento o nei cambiamenti di posizione della testa.
Valuta quindi il risultato su una sequenza video e non soltanto su un singolo fotogramma. Verifica la stabilità dell’identità facciale, la coerenza dei movimenti della bocca, l’assenza di deformazioni temporanee e la continuità delle espressioni.
Ascolta anche la traccia audio separatamente. Una voce convincente associata a un’animazione imprecisa rivela un problema diverso rispetto a un’animazione corretta accompagnata da una voce artificiale o da un’articolazione poco chiara.
Adottare un metodo di test riproducibile
Per individuare l’origine di un difetto, genera innanzitutto una breve sequenza di circa dieci secondi, utilizzando un copione semplice e una dizione naturale.
Mantieni gli stessi parametri durante i primi confronti, quindi modifica una sola variabile alla volta: la foto, il campione vocale oppure il copione. Questo approccio consente di isolare più facilmente i fattori che influenzano il risultato.
Valuta ogni versione secondo quattro criteri: somiglianza del viso, naturalezza della voce, sincronizzazione labiale e stabilità temporale. Se possibile, conserva i file sorgente e i parametri utilizzati per ogni test.
Questo metodo trasforma le regolazioni successive in un processo di ottimizzazione, anziché in una serie di generazioni effettuate casualmente.
Gli errori tecnici più frequenti
Alcuni errori possono essere confusi con i limiti del modello, anche se dipendono in realtà dai file sorgente:
Un’immagine sfocata o sovraesposta, che riduce la leggibilità dei tratti del viso.
Una prospettiva estrema o un viso parzialmente coperto, che complicano la riproduzione dell’identità.
Un audio saturato o con riverbero, che peggiora la qualità del segnale vocale.
Un campione troppo breve o poco rappresentativo, che limita le informazioni disponibili sulla voce.
Un copione denso o ambiguo, che favorisce una dizione artificiale.
Una valutazione basata esclusivamente su un’immagine statica, che nasconde i difetti dell’animazione.
Il primo passo nella diagnosi consiste nell’esaminare separatamente gli input, l’audio generato e il video finale. Questo permette di distinguere un problema nella preparazione dei dati da un limite specifico del motore utilizzato.
Dalla lettura alla pratica
Crea le tue voci fuori campo e i tuoi video IA con Incarneo, senza abbonamento: paghi solo i minuti generati.
Da leggere dopo
Voce fuori campo IA o voce umana: quando scegliere cosa
Una voce fuori campo IA è rapida, economica e modificabile a piacimento. Una voce umana porta un’emozione e una presenza che la sintesi non sempre eguaglia. La scelta giusta dipende meno dalla tecnologia che dal progetto, dal pubblico e dal budget.
Commenti (0)
Ancora nessun commento — avvia la discussione!