Photo et voix de référence : comment obtenir un avatar réaliste
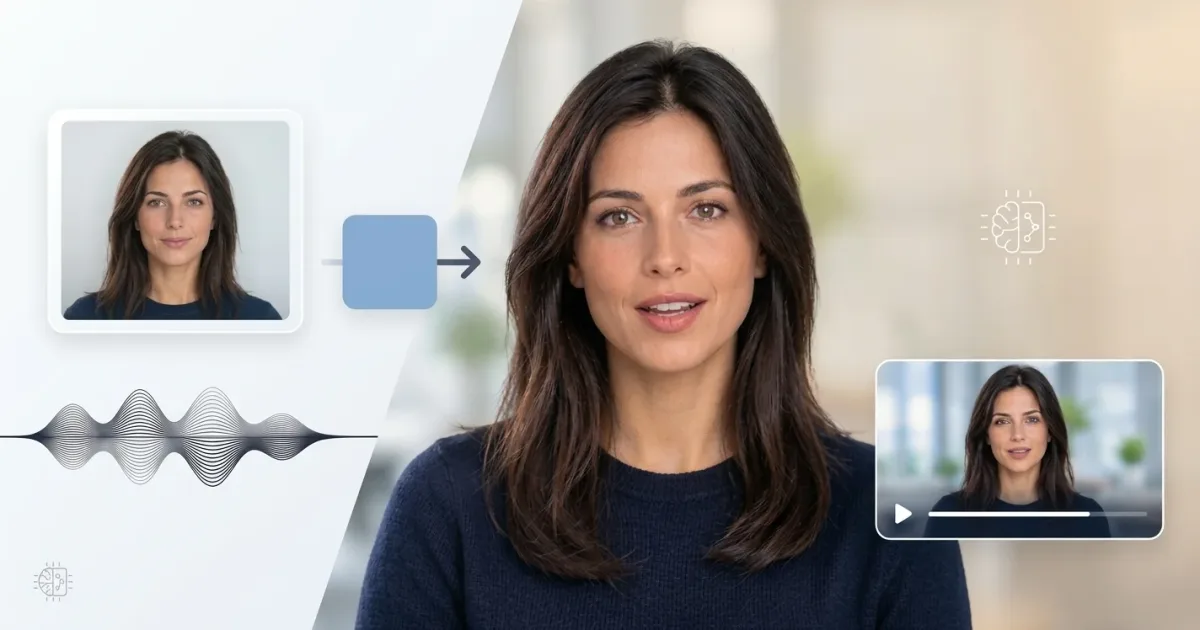
La qualité d’un avatar vidéo dépend autant du modèle de génération que des données qui lui sont fournies. Une photo mal exposée peut limiter la fidélité des traits du visage, tandis qu’un échantillon vocal bruité peut dégrader la restitution de la voix et la synchronisation audiovisuelle.
Sommaire
- Comprendre le rôle des références dans la génération
- Optimiser la photo de référence pour préserver l’identité faciale
- Maîtriser l’éclairage, le contraste et le cadrage
- Préparer un échantillon vocal exploitable
- Comprendre la durée et le contenu de la référence vocale
- Adapter le script à la synthèse vocale et à la synchronisation labiale
- Contrôler la cohérence audiovisuelle
- Adopter une méthode de test reproductible
- Les erreurs techniques les plus fréquentes
Comprendre le rôle des références dans la génération
Un système de génération d’avatar vidéo exploite différentes informations pour produire une séquence cohérente. Selon l’architecture utilisée, la photo peut servir à conditionner l’apparence de l’avatar, tandis que l’audio ou le texte pilote la parole et, directement ou indirectement, les mouvements du visage.
La qualité des références influence donc plusieurs dimensions du résultat : conservation de l’identité, rendu des détails faciaux, naturel des expressions et cohérence entre les mouvements des lèvres et le signal vocal.
Une distinction est importante : une référence de qualité ne garantit pas à elle seule une génération parfaite. Le résultat dépend également du modèle, de ses limites et de la manière dont il interprète les entrées. L’objectif est de lui fournir des données suffisamment claires et cohérentes pour réduire les ambiguïtés.
Optimiser la photo de référence pour préserver l’identité faciale
Pour la plupart des générateurs d’avatars à partir d’une image, une photo frontale constitue un point de départ fiable. Le visage doit être net, suffisamment grand dans l’image et visible dans son intégralité. Le regard dirigé vers l’objectif et une expression neutre ou légèrement souriante facilitent l’obtention d’une apparence stable.
Évitez les rotations importantes de la tête, les occlusions, les filtres de beauté et les retouches qui modifient la géométrie du visage. Ces éléments peuvent compliquer l’interprétation des traits ou favoriser des variations d’apparence au cours de la vidéo.
La résolution doit permettre de distinguer les yeux, le nez, la bouche et les contours du visage. Augmenter artificiellement la définition d’une image floue ne recrée pas les détails absents. Mieux vaut repartir d’une photographie nette que compter sur un traitement d’amélioration.
Maîtriser l’éclairage, le contraste et le cadrage
L’éclairage ne sert pas uniquement à améliorer l’esthétique de la photo. Il détermine aussi la visibilité des caractéristiques faciales qui permettent de distinguer les volumes et les contours.
Une lumière douce, diffuse et relativement uniforme limite les ombres dures sur les yeux, le nez et la bouche. Un contre-jour important peut sous-exposer le visage, tandis qu’une lumière frontale trop intense peut écraser certains reliefs et créer des zones surexposées.
Privilégiez un cadrage frontal, avec la tête et les épaules visibles si le format le permet. Évitez les recadrages extrêmes et les perspectives inhabituelles liées à un appareil placé trop haut ou trop bas.
Test pratique : comparez deux images de la même personne, l’une prise en contre-jour et l’autre face à une fenêtre. À cadrage identique, la seconde présente généralement des traits plus lisibles et une meilleure répartition des détails. C’est cette lisibilité qu’il faut rechercher, sans confondre netteté et suraccentuation artificielle.
Préparer un échantillon vocal exploitable
La voix de référence fournit au système des informations sur le timbre, la texture vocale et, selon l’outil, certains aspects du rythme ou de l’intonation. La captation doit donc préserver le signal vocal sans introduire d’artefacts inutiles.
Enregistrez dans une pièce calme, avec peu de réverbération. Placez le microphone à distance constante de la bouche, généralement à une dizaine ou une vingtaine de centimètres selon le matériel, et légèrement de côté pour limiter les plosives. Ajustez le niveau d’entrée afin d’éviter l’écrêtage.
Privilégiez un enregistrement non compressé, par exemple en WAV PCM, lorsque le service l’accepte. Une fréquence d’échantillonnage de 44,1 ou 48 kHz et une résolution de 16 bits constituent des choix courants pour une captation propre, mais les spécifications du générateur restent prioritaires.
Évitez la réduction de bruit agressive, la réverbération ajoutée et les traitements qui modifient le timbre. Un signal artificiellement nettoyé peut introduire des artefacts plus gênants que le bruit initial.
Comprendre la durée et le contenu de la référence vocale
Un échantillon vocal doit être assez long pour fournir une représentation exploitable de la voix, sans devenir inutilement répétitif. La durée optimale dépend du système : certains outils fonctionnent avec quelques secondes, tandis que d’autres bénéficient d’un extrait plus long.
Privilégiez plusieurs phrases naturelles plutôt qu’une succession de mots isolés. Les variations de hauteur, les transitions entre les sons, les pauses et les différentes formes de phrases donnent une représentation plus complète de la manière de parler.
Un extrait monotone ne reflète pas nécessairement la prosodie habituelle du locuteur. À l’inverse, une interprétation excessivement théâtrale peut donner une référence peu représentative de sa voix quotidienne.
Utilisez uniquement votre voix ou un enregistrement pour lequel vous disposez de l’autorisation nécessaire. La fidélité technique ne dispense pas du respect du consentement et des règles applicables à la reproduction vocale.
Adapter le script à la synthèse vocale et à la synchronisation labiale
Le script agit directement sur la structure temporelle de la parole générée. Une phrase longue et dense peut entraîner un débit peu naturel ou limiter les pauses nécessaires à une interprétation fluide.
Écrivez les nombres, dates, abréviations et acronymes de façon à rendre leur prononciation explicite. Les signes de ponctuation contribuent à structurer le rythme, même si leur effet précis dépend du moteur de synthèse vocale.
La synchronisation labiale, ou lip-sync, consiste à aligner les mouvements de la bouche sur la parole. Elle ne dépend pas uniquement de la durée totale de l’audio : les transitions entre phonèmes, les consonnes, les voyelles et les silences jouent également un rôle.
Pour faciliter cet alignement, évitez les formulations ambiguës et vérifiez la prononciation des termes techniques, des noms propres et des acronymes. Si le système accepte un audio préenregistré, vérifiez que la piste utilisée pour l’animation correspond exactement à celle qui sera diffusée dans la vidéo finale.
Contrôler la cohérence audiovisuelle
Un avatar peut sembler réaliste dans une image fixe tout en présentant des défauts lors de l’animation. Les problèmes apparaissent notamment dans les transitions entre expressions, les mouvements de la mâchoire, les clignements des yeux ou les changements de position de la tête.
Évaluez donc le résultat sur une séquence vidéo, et non uniquement sur une image extraite. Vérifiez la stabilité de l’identité faciale, la cohérence des mouvements de bouche, l’absence de déformations temporaires et la continuité des expressions.
Écoutez également la piste audio séparément. Une voix convaincante associée à une animation imprécise révèle un problème différent d’une animation correcte accompagnée d’une voix artificielle ou mal articulée.
Adopter une méthode de test reproductible
Pour identifier l’origine d’un défaut, générez d’abord une séquence courte d’environ dix secondes, avec un script simple et une diction naturelle.
Conservez les mêmes paramètres pendant les premières comparaisons, puis modifiez une seule variable à la fois : photo, échantillon vocal ou script. Cette approche permet d’isoler plus facilement les facteurs qui influencent le résultat.
Évaluez chaque version selon quatre critères : fidélité du visage, naturel de la voix, synchronisation labiale et stabilité temporelle. Si possible, conservez les fichiers sources et les paramètres utilisés pour chaque essai.
Cette méthode transforme les ajustements successifs en un processus d’optimisation plutôt qu’en une série de générations réalisées au hasard.
Les erreurs techniques les plus fréquentes
Certaines erreurs peuvent être confondues avec les limites du modèle alors qu’elles proviennent des fichiers sources :
Une image floue ou surexposée, qui réduit la lisibilité des traits.
Une perspective extrême ou un visage partiellement masqué, qui complique la restitution de l’identité.
Un audio écrêté ou réverbérant, qui dégrade la qualité du signal vocal.
Un échantillon trop court ou peu représentatif, qui limite les informations disponibles sur la voix.
Un script dense ou ambigu, qui favorise une diction artificielle.
Une évaluation fondée uniquement sur une image fixe, qui masque les défauts d’animation.
La première étape du diagnostic consiste à examiner séparément les entrées, l’audio généré et la vidéo finale. Cela permet de distinguer un problème de préparation des données d’une limite propre au moteur utilisé.
Questions fréquentes
Vous souhaitez mettre ces principes en pratique ?
Découvrez Incarneo et créez votre premier avatar à partir de références visuelles et vocales adaptées.
Passez de la lecture à la pratique
Créez vos propres voix off et vidéos IA avec Incarneo, sans abonnement : vous ne payez que les minutes générées.
À lire ensuite
Voix off IA ou voix humaine : quand choisir quoi ?
Une voix off IA est rapide, économique et modifiable à volonté. Une voix humaine apporte une émotion et une présence que la synthèse ne reproduit pas toujours. Le bon choix dépend moins de la technologie que de votre projet, de votre public et de votre budget.
Commentaires (0)
Aucun commentaire pour le moment — lancez la discussion !