Referenzfoto und Stimme: So erstellen Sie einen realistischen Avatar
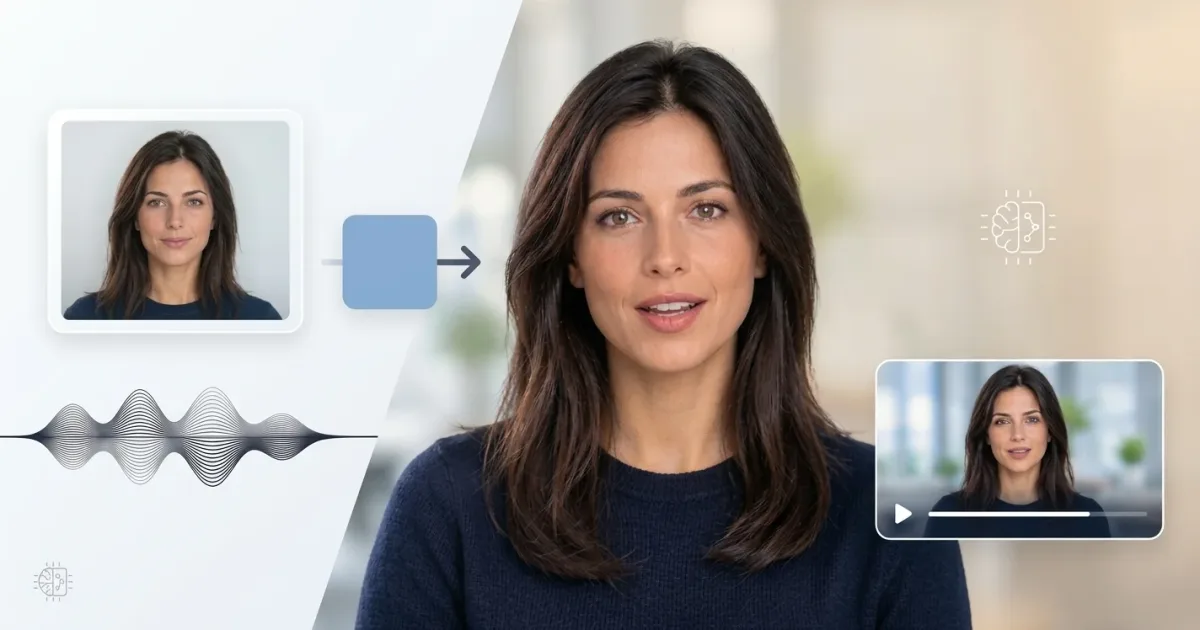
Die Qualität eines Video-Avatars hängt vom Modell und den Daten ab. Schlechte Belichtung schadet den Gesichtszügen, während verrauschter Ton die Stimme und die audiovisuelle Synchronisation verschlechtert.
Inhaltsverzeichnis
- Die Rolle von Referenzdaten bei der Generierung verstehen
- Das Referenzfoto optimieren, um die Gesichtsidentität zu bewahren
- Beleuchtung, Kontrast und Bildausschnitt kontrollieren
- Eine geeignete Sprachprobe vorbereiten
- Dauer und Inhalt der Sprachreferenz verstehen
- Das Skript an Sprachsynthese und Lippensynchronisation anpassen
- Die audiovisuelle Konsistenz überprüfen
- Eine reproduzierbare Testmethode anwenden
- Die häufigsten technischen Fehler
Die Rolle von Referenzdaten bei der Generierung verstehen
Ein System zur Generierung von Video-Avataren nutzt verschiedene Informationen, um eine zusammenhängende Sequenz zu erzeugen. Je nach verwendeter Architektur kann das Foto das Erscheinungsbild des Avatars vorgeben, während Audio oder Text die Sprache und direkt oder indirekt die Gesichtsbewegungen steuern.
Die Qualität der Referenzdaten beeinflusst daher mehrere Aspekte des Ergebnisses: die Bewahrung der Identität, die Wiedergabe von Gesichtsdetails, die Natürlichkeit der Mimik und die Übereinstimmung zwischen Lippenbewegungen und Audiosignal.
Dabei ist eine Unterscheidung wichtig: Hochwertige Referenzdaten allein garantieren keine perfekte Generierung. Das Ergebnis hängt auch vom Modell, seinen Einschränkungen und der Art ab, wie es die Eingaben interpretiert. Ziel ist es, möglichst klare und konsistente Daten bereitzustellen, um Mehrdeutigkeiten zu reduzieren.
Das Referenzfoto optimieren, um die Gesichtsidentität zu bewahren
Für die meisten bildbasierten Avatar-Generatoren ist ein frontal aufgenommenes Foto ein zuverlässiger Ausgangspunkt. Das Gesicht sollte scharf, ausreichend groß im Bild und vollständig sichtbar sein. Ein direkter Blick in die Kamera sowie ein neutraler oder leicht lächelnder Gesichtsausdruck erleichtern die Erzeugung eines konsistenten Erscheinungsbilds.
Vermeiden Sie starke Kopfdrehungen, Verdeckungen des Gesichts, Beauty-Filter und Retuschen, die die Gesichtsgeometrie verändern. Solche Elemente können die Interpretation der Gesichtszüge erschweren oder im Verlauf des Videos zu Veränderungen des Erscheinungsbilds führen.
Die Auflösung sollte ausreichen, um Augen, Nase, Mund und Gesichtskonturen klar zu erkennen. Eine künstliche Erhöhung der Auflösung eines unscharfen Bildes stellt fehlende Details nicht wieder her. Es ist besser, mit einer scharfen Fotografie zu beginnen, als sich auf eine nachträgliche Bildverbesserung zu verlassen.
Beleuchtung, Kontrast und Bildausschnitt kontrollieren
Die Beleuchtung dient nicht nur dazu, die Ästhetik des Fotos zu verbessern. Sie bestimmt auch, wie gut die Gesichtsmerkmale erkennbar sind, anhand derer sich Formen und Konturen unterscheiden lassen.
Weiches, diffuses und möglichst gleichmäßiges Licht reduziert harte Schatten im Bereich der Augen, der Nase und des Mundes. Starkes Gegenlicht kann dazu führen, dass das Gesicht unterbelichtet wird. Zu intensives frontales Licht kann hingegen bestimmte Gesichtskonturen abflachen und überbelichtete Bereiche erzeugen.
Wählen Sie eine frontale Perspektive. Wenn das Format es zulässt, sollten Kopf und Schultern sichtbar sein. Vermeiden Sie extreme Bildausschnitte und ungewöhnliche Perspektiven, die entstehen, wenn die Kamera zu hoch oder zu niedrig positioniert ist.
Praktischer Test: Vergleichen Sie zwei Fotos derselben Person: eines mit Gegenlicht und eines mit Blick in Richtung eines Fensters. Bei identischem Bildausschnitt weist das zweite Bild in der Regel klarer erkennbare Gesichtszüge und eine gleichmäßigere Detailverteilung auf. Genau diese Klarheit sollten Sie anstreben, ohne Schärfe mit künstlicher Überschärfung zu verwechseln.
Eine geeignete Sprachprobe vorbereiten
Die Referenzstimme liefert dem System Informationen über Stimmklang, Stimmcharakter und, abhängig vom verwendeten Tool, bestimmte Aspekte von Rhythmus und Intonation. Bei der Aufnahme sollte das Sprachsignal daher möglichst unverfälscht bleiben, ohne unnötige Artefakte einzuführen.
Nehmen Sie in einem ruhigen Raum mit möglichst wenig Nachhall auf. Halten Sie einen konstanten Abstand zwischen Mikrofon und Mund ein. Je nach Ausrüstung sind etwa 10 bis 20 Zentimeter üblich. Positionieren Sie das Mikrofon leicht seitlich, um Plosivlaute zu reduzieren. Passen Sie den Eingangspegel so an, dass keine Übersteuerung entsteht.
Wenn der Dienst es unterstützt, sollten Sie ein unkomprimiertes Aufnahmeformat wie PCM-WAV bevorzugen. Eine Abtastrate von 44,1 oder 48 kHz und eine Auflösung von 16 Bit sind gängige Einstellungen für saubere Sprachaufnahmen. Die technischen Vorgaben des jeweiligen Generators haben jedoch stets Vorrang.
Vermeiden Sie aggressive Rauschunterdrückung, künstlich hinzugefügten Hall und Bearbeitungen, die den Stimmklang verändern. Ein künstlich bereinigtes Signal kann Artefakte enthalten, die störender sind als das ursprüngliche Hintergrundrauschen.
Dauer und Inhalt der Sprachreferenz verstehen
Eine Sprachprobe sollte lang genug sein, um eine brauchbare Repräsentation der Stimme zu liefern, ohne unnötig repetitiv zu werden. Die optimale Dauer hängt vom jeweiligen System ab: Einige Tools funktionieren bereits mit wenigen Sekunden, während andere von einer längeren Aufnahme profitieren.
Verwenden Sie mehrere natürlich gesprochene Sätze statt einer Folge einzelner Wörter. Variationen in der Tonhöhe, Übergänge zwischen Lauten, Pausen und unterschiedliche Satzstrukturen vermitteln ein umfassenderes Bild der Sprechweise.
Eine monotone Aufnahme spiegelt die typische Prosodie einer Person möglicherweise nicht angemessen wider. Umgekehrt kann eine übermäßig theatralische Darbietung eine Referenz erzeugen, die nicht der alltäglichen Stimme entspricht.
Verwenden Sie ausschließlich Ihre eigene Stimme oder eine Aufnahme, für die Sie über die erforderliche Genehmigung verfügen. Technische Wiedergabetreue entbindet nicht von der Pflicht, Einwilligungen und geltende Vorschriften zur Reproduktion von Stimmen zu beachten.
Das Skript an Sprachsynthese und Lippensynchronisation anpassen
Das Skript beeinflusst unmittelbar die zeitliche Struktur der generierten Sprache. Ein langer, informationsreicher Satz kann zu einem unnatürlichen Sprechtempo führen oder die für einen flüssigen Vortrag erforderlichen Pausen einschränken.
Schreiben Sie Zahlen, Datumsangaben, Abkürzungen und Akronyme so aus, dass die gewünschte Aussprache eindeutig ist. Satzzeichen tragen zur Strukturierung des Sprechrhythmus bei, auch wenn ihre genaue Wirkung vom jeweiligen Text-to-Speech-System abhängt.
Die Lippensynchronisation, auch Lip-Sync genannt, bezeichnet die Abstimmung der Mundbewegungen auf die gesprochene Sprache. Sie hängt nicht allein von der Gesamtdauer der Audiodatei ab: Auch Übergänge zwischen Phonemen, Konsonanten, Vokalen und Sprechpausen spielen eine Rolle.
Um diese Abstimmung zu erleichtern, sollten Sie mehrdeutige Formulierungen vermeiden und die Aussprache von Fachbegriffen, Eigennamen und Akronymen überprüfen. Wenn das System vorab aufgenommenes Audio unterstützt, stellen Sie sicher, dass die für die Animation verwendete Tonspur exakt mit der Tonspur übereinstimmt, die im fertigen Video wiedergegeben wird.
Die audiovisuelle Konsistenz überprüfen
Ein Avatar kann auf einem Standbild realistisch wirken und während der Animation dennoch Fehler aufweisen. Probleme treten insbesondere bei Übergängen zwischen Gesichtsausdrücken, bei Kieferbewegungen, beim Blinzeln oder bei Veränderungen der Kopfposition auf.
Bewerten Sie das Ergebnis daher anhand einer Videosequenz und nicht ausschließlich anhand eines einzelnen Standbilds. Überprüfen Sie die Konsistenz der Gesichtsidentität, die Stimmigkeit der Mundbewegungen, das Auftreten vorübergehender Verformungen und die Kontinuität der Gesichtsausdrücke.
Hören Sie sich außerdem die Audiospur separat an. Eine überzeugende Stimme in Verbindung mit unpräziser Animation weist auf ein anderes Problem hin als eine korrekte Animation mit einer künstlich klingenden Stimme oder undeutlicher Artikulation.
Eine reproduzierbare Testmethode anwenden
Um die Ursache eines Fehlers zu identifizieren, sollten Sie zunächst eine kurze Sequenz von etwa zehn Sekunden mit einem einfachen Skript und natürlicher Sprechweise generieren.
Behalten Sie bei den ersten Vergleichen dieselben Einstellungen bei und ändern Sie anschließend jeweils nur eine Variable: das Foto, die Sprachprobe oder das Skript. So lassen sich die Faktoren, die das Ergebnis beeinflussen, leichter isolieren.
Bewerten Sie jede Version anhand von vier Kriterien: Ähnlichkeit des Gesichts, Natürlichkeit der Stimme, Lippensynchronisation und zeitliche Konsistenz. Bewahren Sie nach Möglichkeit die Quelldateien und die für jeden Test verwendeten Einstellungen auf.
Mit dieser Methode werden schrittweise Anpassungen zu einem systematischen Optimierungsprozess statt zu einer Reihe zufälliger Generierungsversuche.
Die häufigsten technischen Fehler
Einige Fehler werden möglicherweise mit den Einschränkungen des Modells verwechselt, obwohl sie tatsächlich auf die Quelldateien zurückzuführen sind:
Ein unscharfes oder überbelichtetes Bild, das die Erkennbarkeit der Gesichtszüge beeinträchtigt.
Eine extreme Perspektive oder ein teilweise verdecktes Gesicht, wodurch die Wiedergabe der Identität erschwert wird.
Ein übersteuertes oder halliges Audiosignal, das die Qualität der Sprachaufnahme verschlechtert.
Eine zu kurze oder nicht repräsentative Sprachprobe, die den verfügbaren Informationsgehalt über die Stimme einschränkt.
Ein dichtes oder mehrdeutiges Skript, das eine unnatürliche Sprechweise begünstigt.
Eine Bewertung, die ausschließlich auf einem Standbild basiert und dadurch Animationsfehler übersieht.
Der erste Schritt bei der Fehlerdiagnose besteht darin, die Eingabedaten, das generierte Audio und das fertige Video getrennt zu untersuchen. So lässt sich zwischen Problemen bei der Datenvorbereitung und den eigentlichen Einschränkungen des verwendeten Generierungsmodells unterscheiden.
Vom Lesen zur Praxis
Erstellen Sie eigene KI-Voice-overs und -Videos mit Incarneo, ohne Abo: Sie zahlen nur die generierten Minuten.
Weiterlesen
KI-Voice-Over oder menschliche Stimme: wann was wählen?
Eine KI-Stimme ist schnell, günstig und lässt sich beliebig anpassen. Eine menschliche Stimme bringt Emotion und Präsenz mit, die Synthese nicht immer erreicht. Die richtige Wahl hängt weniger von der Technik ab als von Projekt, Publikum und Budget.
Kommentare (0)
Noch keine Kommentare — starten Sie die Diskussion!